Mostrando entradas con la etiqueta Utilidades. Mostrar todas las entradas

viernes, 26 de julio de 2013

Proxy en Wget

Como siempre por cosas de trabajo me encuentro en la oportunidad de incluir esta nota sobre como configurar wget en una red que emplea proxy con autentificación.

El procedimiento en realidad es muy sencillo, basta simplemente con agregar los detalles del proxy a la configuración de Wget, para ello simplemente es necesario editar el archivo /etc/wgetrc y descomentar o agregar las siguientes lineas:

https_proxy = http://192.168.53.37:8080
http_proxy = http://192.168.53.37:8080
ftp_proxy = http://192.168.53.37:8080

proxy-user = e06827
proxy-passwd = @@Pplqm51ed/9

use_proxy = on


En el caso que nuestro proxy no emplee autentificación podemos omitir proxy-user y proxy-passwd.

lunes, 22 de julio de 2013

NFS

Compartir archivos por la red es hoy en dia una tarea trivial; tanto, que incluso en GNU/Linux disponemos de gran variedad de opciones, cada una a medida de las diferentes necesidades.

En esta oportunidad voy a hablar sobre una de ellas NFS, uno de mis tantos pendientes en el Blog y que al fin tengo oportunidad de saldar gracias al día a dia del trabajo. En cualquier caso, de manera sencilla podemos decir que NFS es:

"es un protocolo de nivel de aplicación, según el Modelo OSI. Es utilizado para sistemas de archivos distribuido en un entorno de red de computadoras de área local. Posibilita que distintos sistemas conectados a una misma red accedan a ficheros remotos como si se tratara de locales. Originalmente fue desarrollado en 1984 por Sun Microsystems, con el objetivo de que sea independiente de la máquina, el sistema operativo y el protocolo de transporte, esto fue posible gracias a que está implementado sobre los protocolos XDR (presentación) y ONC RPC (sesión).1 El protocolo NFS está incluido por defecto en los Sistemas Operativos UNIX y la mayoría de distribuciones Linux. "

Wikipedia.

Existen tres versiones de NFS que se utilizan hoy en día:

  • NFSv2: Es la versión más antigua y mejor soportada.
  • NFSv3: Tiene más características que NFSv2, como el manejo de archivos de tamaño variable y mejores informes de errores. Sólo es parcialmente compatible con los clientes para NFSv2.
  • NFSv4: Es la versión más moderna, y, entre otras cosas, incluye soporte para seguridad a través de Kerberos, soporte para ACL y utiliza operaciones con descripción del estado.
En general, hay serias consideraciones que debemos realizar al momento de optar por esta solución, sobre todo en lo relacionado con la seguridad (no voy a entrar en detalles sobre esto en el articulo). En todo caso para aquellos que ya han decidido ir adelante con la solución veamos el proceso de Setup de NFS.

Equipamento Necesario:


En la mayoria de las distribuciones linux, el paquete nfs-utils (el paquete necesario para instalar tanto el cliente como el servidor NFS) viene incluido por default, pero en caso de no ser así simplemente debemos instalarlo con nuestro manejador de paquete. En mi caso:

# yum install nfs-utils

Alternativamente, si son de las personas que prefieren realizar todo por entorno gráfico, seguramente les gustara instalar:

# yum install system-config-nfs

Con esta aplicación pueden ejecutar de manera grafica cada uno de los pasos que voy a comentar aca (la configuración por esta utilidad la dejare fuera del articulo).

Definir los puertos:

En entornos RHEL es necesario definir los puertos que utilizara NFS, debido a que el firewall es incapaz de abrir dinámicamente los puertos aleatorios que de un modo predeterminado utiliza este.

Para esto, lo que debemos es editar el archivo /etc/sysconfig/nfs, habilitando o modificando los siguientes parametros:

RQUOTAD_PORT=875
LOCKD_TCPPORT=32803
LOCKD_UDPPORT=32769
MOUNTD_PORT=892
STATD_PORT=662

* Este paso lo podemos omitir en caso de que vallamos a ejecutar NFS sin Firewall en una red local.

Iniciar NFS:

NFS requiere los servicios rpcbind y nfslock para ejecutarse, por lo tanto estos deben estar activos y funcionando:

# service rpcbind start
# service nfslock start

Para iniciar nfs:

# service nfs start

Para evitar ejecutar estos pasos cada vez que se inicie el equipo y hacer que el sistema autoinicie los servicios ejecutamos:

# chkconfig nfs on
# chkconfig rpcbind on
# chkconfig nfslock on

Modificando host permitidos y denegados:

Con el objeto de hacer el servicio un poco mas seguro, es posible configurar una lista de host permitidos y denegados; de esta manera no todos en la red pueden acceder a nuestro recurso compartido. Para hacer esto es necesario que:

Editar el archivo /etc/hosts.deny y añadir el siguiente contenido:

portmap: ALL
lockd: ALL
mountd: ALL
rquotad: ALL
statd: ALL

Posteriormente, vamos a modificar /etc/hosts.allow para de esta manera indicar cuales hosts tendrán permitida la conexión:

portmap: 192.168.70.0/25, 172.16.1.0/28, 10.0.1.0/29
lockd: 192.168.70.0/25, 172.16.1.0/28, 10.0.1.0/29
mountd: 192.168.70.0/25, 172.16.1.0/28, 10.0.1.0/29
rquotad: 192.168.70.0/25, 172.16.1.0/28, 10.0.1.0/29
statd: 192.168.70.0/25, 172.16.1.0/28, 10.0.1.0/29

* Esto asumiendo que se permitirá acceso a las redes 192.168.70.0/25, 172.16.1.0/28 y 10.0.1.0/29 (se debe personalizar en base a nuestras necesidades).

Modificaciones en el Firewall:

Para servidores de NFSv4, en realidad sólo es necesario abrir en el muro cortafuegos el puerto 2049/TCP (nfs), pues es esta versión dejó de depender del servicio de mapa de puertos (portmap). Sin embargo, para poder trabajar con compatibilidad para NFSv2 y NFSv3, es necesario abrir los puertos 111/UDP, 111/TCP, 662/TCP, 662/UDP, 875/TCP, 875/UDP, 892/TCP, 892/UDP, 2029/TCP, 2049/UDP, 32803/TCP y 32769/UDP. Los puertos que se abran para los servicios lockd, mountd, rquotad y statd deben corresponder con los mismo puertos definidos el archivo /etc/sysconfig/nfs.

Para aplicar estos cambios de forma definitiva modificamos el archivo  /etc/sysconfig/iptables asi:

-A INPUT -m state --state NEW -m tcp -p tcp --dport 2049 -j ACCEPT
-A INPUT -m state --state NEW -m udp -p udp --dport 2049 -j ACCEPT
-A INPUT -m state --state NEW -m tcp -p tcp --dport 111 -j ACCEPT
-A INPUT -m state --state NEW -m udp -p udp --dport 111 -j ACCEPT
-A INPUT -m state --state NEW -m tcp -p tcp --dport 662 -j ACCEPT
-A INPUT -m state --state NEW -m udp -p udp --dport 662 -j ACCEPT
-A INPUT -m state --state NEW -m tcp -p tcp --dport 875 -j ACCEPT
-A INPUT -m state --state NEW -m udp -p udp --dport 875 -j ACCEPT
-A INPUT -m state --state NEW -m tcp -p tcp --dport 892 -j ACCEPT
-A INPUT -m state --state NEW -m udp -p udp --dport 892 -j ACCEPT
-A INPUT -m state --state NEW -m tcp -p tcp --dport 32803 -j ACCEPT
-A INPUT -m state --state NEW -m udp -p udp --dport 32769 -j ACCEPT

Finalmente, para que todo surja efecto reiniciamos las reglas iptables:

# service iptables restart

Exportando:

NFS funciona simplemente agregando los recursos a compartir y sus reglas en el archivo /etc/exports. Este archivo tiene una estructura simple, pero rigida:

/directorio/a/compartir  EquiposQueConectaranAlRecurso(Reglas)

Podemos obtener un buen listado de ejemplos acá.

Montando el filesystem en el cliente:

Para montar el sistema de archivos NFS se emplea el comando mount:

# mount -t nfs servidor:/directorio /punto/de/montaje/local

Para hacer permanente este punto editamos el /etc/fstab agregando una entrada así:

servidor:/directorio   /punto/montaje   nfs4   opciones  0 0


miércoles, 13 de febrero de 2013

Single User RHEL

Una entrada muy corta sobre el modo Single User en RHEL, el modo 1 o la base para ejecutar el recovery en sistemas. En fin, una de las mejores formas para solucionar problemas en el sistema, siempre y cuando por lo menos podamos llegar al nivel del grub en el momento del arranque.

Para iniciar en modo a prueba de fallo simplemente debemos:

  1. Seleccionar una de las entradas de sistema operativo desde el menú del Grub.
  2. Presionar la tecla "e", para ingresar a la opción de edición de los parametros.
  3. Agregar a los parámetros del kernel la opción "single". Alternativamente, si queremos podemos también agregar la opción de indicar nuestro bash (init=/bin/bash).
  4. Finalmente para botear con nuestra modificación desde el menú del grub seleccionamos y tecleamos "b".
  5. Si todo ha ido bien nos dejara en una consola de sistema, en modo mono-usuario sin acceso a la red desde el cual podemos iniciar la reparación de nuestro sistema.

lunes, 28 de enero de 2013

SELinux

La verdad, no voy a entrar en polemica alguna sobre SELinux, por ahora; solo voy a comentar como saber el estatus de SELinux en nuestro RHEL.

El comando sestatus nos retorna la información básica del SELinux, si esta siendo usado y las politicas:


Adicionalmente, podemos conocer el estado del SELinux, con el comando getenforce, el cual nos retornara el Status/Current Mode.


Ip's Virtuales en RHEL

En linux, es posible asignarle mas de una dirección ip a una interfaz física haciendo uso de las llamadas Virtual Ip (VIP). Hoy me veo en la necesidad de configurar algunas y noto que no he hablado de eso por acá, por lo que me tomo un momento para realizar la nota.

En Distros basadas en RHEL este proceso es muy sencillo, basta simplemente con copiar el archivo de configuración que ya tengamos con un nuevo nombre del tipo ifcfg-ethX:X

ifcfg-eth0:
 
DEVICE=eth0 
BOOTPROTO=static 
HWADDR=00:22:ñe:3c:3w:72 
IPADDR=192.168.0.110 
NETMASK=255.255.255.0 
ONBOOT=yes 
GATEWAY=192.168.0.1 
TYPE=Ethernet
 
 
ifcfg-eth0:

DEVICE=eth0:0 
BOOTPROTO=static 
HWADDR=00:22:ñe:3c:3w:72 
IPADDR=192.168.0.111 
NETMASK=255.255.255.0 
ONBOOT=yes 
GATEWAY=192.168.0.1
 TYPE=Ethernet


De similar manera si tenemos configurado un bonding:

ifcfg-bond0:

DEVICE=bond0 
BOOTPROTO=none 
IPADDR=10.200.1.14 
NETMASK=255.255.255.0 
BONDING_OPTS="miimon=100 mode=1 primary=eth0" USERCTL=no
ONBOOT=yes

ifcfg-bond0:0

DEVICE=bond0:0 
BOOTPROTO=none 
IPADDR=10.200.1.118 
NETMASK=255.255.255.0 
ONBOOT=yes

jueves, 10 de enero de 2013

habilitando Mod_Rewrite Apache

En esta pequeña entrada, voy a comentar la forma de habilitar Mod_Rewrite en un Servidor Apache instalado en Fedora 17. El proceso es realmente muy sencillo:

  • Acceder al archivo de configuración del apache (/etc/httpd/conf/httpd.conf) y modificar la linea "AllowOverride", cambiando el parametro de "Limit" a "All". Esto debe hacerse para la directiva "Directory /" y la directiva "Directory /var/www/html".
  • De igual forma, vamos a localizar en el archivo la linea "LoadModule rewrite_module modules/mod_rewrite.so" y verificamos que no se encuentre comentada (no inicia con"#").
  • Luego de realizado el cambio, reiniciamos el servidor apache (service httpd restart) y listo.
Finalmente, podemos realizar una prueba ejecutando el procedimiento comentado en este site.

martes, 8 de enero de 2013

Tomb - Tumbas Criptograficas

No hay secreto alguno al decir que nos encontramos en la era de la información, una época en la que la media de datos por persona es muy alta y en la que llevamos toda clase de información con nosotros; alguna de carácter general otra de carácter privado.

En cualquiera de los casos, casi siempre tenemos toda esta información conviviendo en nuestros dispositivos sin mayor protección, almacenados allí esperando que nada nunca ocurra, pero seamos realistas esto no es lo correcto. Cuantas veces hemos oido de robos de equipos, estravios de dispositivos de almacenamiento, clonación de dispositivos y un largo etcetera que debe llevarnos a la paranoia.

Ante este panorama, lo correcto es iniciar la toma de medidas, empesar a generar para nosotros mismos estandares de proteción, que nos permitan cierta tranquilidad a la hora de manipular nuestra información.

Dicho esto, vamos al grano, Señoras y Señores Tomb:

TOMB

Tomb, tal como se lee en su pagina Web es una utilidad 100% libre que nos permite generar directorios cifrados. Tomb permite encriptar directorios, los cuales pueden incluso transportarse de manera segura ya sea en un dispositivo de almacenamiento externo o a través de la red.

Una de las principales ventajas de tomb es que es bastante simple de usar; este genera directorios tumbas utilizando un  algoritmo llamado "Secreto de Shamir". Estos directorios pueden ser abiertos solamente utilizando una llave que además es protegida por una contraseña elegida por el usuario.

Las llaves creadas por tomb para cada una de las tumbas pueden (y deben) ser cambiadas de lugar para ofrecer mayor seguridad, por ejemplo, puedes crear una tumba y guardar su llave en tu memoria usb para así incrementar la seguridad.

Instalando:

La fuente de Tomb se encuentra disponible desde la pagina del proyecto, en debian o derivados, se puede hacer uso de un repositorio para su instalación (instrucciones), y en arch de dispone de un paquete (aquí). Para el resto de las distros, el procedimiento es instalar directamente de la fuente:

  1. Instalamos en nuestro sistema los pre-requisitos (gcc, gtk2, gtk2-devel, libnotify, zsh).
  2. Descargamos la fuente desde la pagina del proyecto (aquí).
  3. Descomprimimos el archivo (tar -xvf Tomb-xx.tar.gz).
  4. Ingresamos al directorio generado (Cd Tomb-XX).
  5. Configuramos (./configure).
  6. Si todo ha ido bien preparemos la instalacion (make).
  7. Nuevamente, si todo esta correcto entonces instalamos (make install).
Luego de la Instalación ya podemos crearnos nuestra tumba, para ello simplemente debemos:

Creando la Tumba:

  1.  Si no tenemos la Swap cifrada debemos desactivarla (swapoff -a).
  2. Creamos la Tumba (tomb create -s [tamañoDeLaTumba]
    --ignore-swap [nombreDeLaTumba]).
  3. Al terminar de crear la Tumba, se nos pedirá que indiquemos la contraseña para la tumba.
  4. Reconfirmamos la clave.
  5. Listo, obtendremos 2 archivos (la tumba y su llave).

Abriendo la tumba:


  1. tomb -k [rutaALaLlave] open [rutaALaTumba]
  2. Se nos solicitará la contraseña para la tumba
  3. Si todo va correcto, entonces se montara un nuevo dispositivo al cual podemos agregarle todos los archivos que necesitemos.

Cerrando la tumba:

  1. tomb close [nombreDeLaTumba]

Algunas opciones de Tomb


Argumentos:

  • create: crear un nuevo ARCHIVO tomb junto con sus llaves.
  • open: abre un ARCHIVO tomb ya existente en un LUGAR.
  • list: lista todos las tumbas o archivos tomb abiertos o aquel llamado ARCHIVO.
  • close: cierra una tumba llamada ARCHIVO (o todas).
  • slam: cierra la tumba ARCHIVO y mata todos los pids que utilice.
  • passwd: cambia la contraseña de la llave de algún ARCHIVO de tumba.

Opciones:

  •  -s: indica el tamaño del archivo tomb durante su creación (en MB).
  •  -k: ruta al archivo a utilizar para abrir una tumba.
  •  -n: no procesa los ganchos encontrados en la tumba.
  •  -o: opciones especiales para montaje (por default: rw,noatime,nodev).
  •  -h: muestra esta ayuda.
  •  -v: sobre la versión de la herramienta.
  •  -q: se ejecuta silenciosamente sin mostrar información.
  •  -D: muestra información (debugging) del proceso durante el arranque. 

viernes, 4 de enero de 2013

Proxy en consola

Hace un momento me acabo de ver en la necesidad de setear un proxy para navegar en un equipo que no tiene interfaz gráfica, la sentencia es muy sencilla, pero suelo olvidar el orden por lo que decidí dar un ojo para refrescar; pero mayor sorpresa me lleve al encontrar que no he escrito un post sobre esto... "Yo y mis pendientes", en fin ....

Desde la consola es muy fácil utilizar la variable "http_proxy", para conectarnos desde la sesión/aplicación en modo texto al Internet. Para ello simplemente debemos:

Ejecutar el siguiente comando para configurar el servidor proxy:

$ export http_proxy=http://servidor-ip:port/
  
 
Si nuestro proxy requiere autentificación entonces ejecutamos:

$ export http_proxy=http://user:password@server-ip:port/

Finalmente, podemos configurar el proxy para todos los usuarios; para ello simplemente basta con copiar cualquiera de los comandos antes descritos en el archivo "/etc/profile".

viernes, 14 de diciembre de 2012

"Recuperar" contraseña en Windows

Si, claramente el titulo puede verse extraño en un blog dedicado a hablar sobre linux, pero ya que todo se basa en la explotación de un error de Microsoft mediante el uso de una distro Linux no me parecio una mala idea publicarlo aqui. Dicho esto vamos a la materia:

  1. Iniciar el equipo con nuestra distro Linux predilecta.
  2. Montar el disco (Windows) de nuestra maquina.
  3. Acceder a la ruta Windows\System32
  4. Renombrar "Magnify.exe" por "Magnify.exe.bak".
  5. Copiar y pegar "cmd.exe"
  6. renombrar el archivo copiado como Magnify.exe
  7. Reiniciar el equipo y arrancar por windows.
  8. Al llegar a la pantalla de inicio presionar el botón "Accesibilidad".
  9. En el menu que se apertura seleccionamos la "Lupa", lo cual nos cargara en realidad una consola con privilegios admin
  10. Una vez allí listamos los usuario del sistema (net users)
  11. Para cambiar la cuenta del usuario simplemente ejecutamos net users usuarioACambiar
  12. Si cambiamos la cuenta de admin debemos habilitarla (no viene por defecto), para ello ejecutamos net users administrador /active:yes
  13. Reiniciamos nuevamente (vamos es tipico en la ventanita).
  14. Ya esta listo !!!

jueves, 13 de diciembre de 2012

Busquedas PRO en Google o Google Hacking.

En la actualidad, no se encuentra para nada difundido el tema del correcto uso de los buscadores en internet. Para la mayoria de las personas, el buscador es mas una especie de Gúru que todo lo sabe al cual se le hacen preguntas como si fuera un humano... ( :-/  ¿¿??)

La verdad (en mi opinión personal), nada esta mas alejado de la realidad, y realizar busquedas partiendo de colocar preguntas en el buscador puede no ser la mejor manera de hallar información sobre un tema en la red; pero entonces, cuales son las mejores practicas a la hora de emplear Google ¿¿ :-/ ?? ...

Recomendaciones Basicas:

Las siguientes recomendaciones son extraídas de las ayudas básicas para las búsquedas de Google (aquí), pero me he permitido realizar algunos cambios...

  1. No te compliques: no es mala idea iniciar buscando el termino o sujeto del tema especifico.
  2. Añade palabras relevantes: de esta manera lograras resultados mas específicos, incluye términos que puedan asociarse directamente a lo que deseas encontrar.
  3. Busca pensando en como escribiría un autor: si estas buscando ayuda por un dolor de cabeza, escribir simplemente "Me duele la cabeza", puede no producir resultados útiles que te brinden soluciones al mal que te aqueja, por el contrario puede ser una mejor practica buscar algo como "Dolor de Cabeza Remedios" u otros términos similares (mas adelante les compartiré como hacer que el buscador se encargue de usar sinónimos a ciertos términos).
  4. Usa solo palabras importantes en lugar de frases o preguntas completas: el ejemplo de google va genial, en lugar de "país en el que los murciélagos son un augurio de mala suerte", viene mejor " murciélagos mala suerte".

Vistos los conceptos básicos sobre búsquedas, llega el momento de profundizar un poco mas, por lo que ahora vamos a ver como limitar nuestras búsquedas un poco mas. Igual que el caso anterior, estos primeros detalles vienen directo desde Google (aquí).

                        
Buscar una palabra o una frase exactas
"consulta de búsqueda"
Utiliza comillas para buscar una palabra o un conjunto de palabras exactas en un orden concreto sin aplicar las mejoras habituales, como la corrección ortográfica o la búsqueda de sinónimos. Esta opción resulta útil si buscas la letra de una canción o una cita de una obra literaria.
[ "chiquitita dime por qué" ] Sugerencia: utiliza las comillas solo si estás buscando una palabra o una frase muy concreta, ya que podrían excluirse resultados útiles por error.
Excluir una palabra
-consulta
Añade un guión (-) delante de una palabra para excluir todos los resultados que incluyan dicha palabra. Esto resulta especialmente útil en el caso de sinónimos como Jaguar la marca de coche y jaguar el animal.    
[ velocidad del jaguar -coche ]      Sugerencia: también puedes excluir resultados con otros operadores. Por ejemplo, puedes excluir todos los resultados de un sitio en particular.     
[ pandas -site:wikipedia.org ]  
Incluir palabras similares
~consulta
Normalmente, algunas palabras de la consulta original se pueden sustituir por sinónimos. Añade el signo de tilde (~) inmediatamente delante de una palabra para buscar esa palabra y otros sinónimos.    
[ información ~alimentaria ] incluye los resultados de "información nutricional".  
Limitar la búsqueda a un sitio o dominio
site: consulta
El operador "site:" permite buscar información en un mismo sitio web como, por ejemplo, todas las veces que se menciona la palabra "Olimpiadas" en el sitio web de The New York Times.    
[ Olimpiadas site:nytimes.com ]      Sugerencia: también puedes buscar en un determinado dominio de nivel superior como .org, .edu o en un dominio de nivel superior de país como .es o .de.     
[ Olimpiadas site:.es ]  
Incluir un comodín
consulta * consulta
Utiliza un asterisco (*) en una consulta como marcador de posición para cualquier término "comodín" desconocido. Combínalo con el uso de comillas para buscar variaciones de esta frase exacta o para recordar palabras en medio de una frase.     
[ "quien siembra * recoge *" ]  
Buscar al menos una de las palabras de la consulta
consulta OR consulta
Si quieres buscar páginas que incluyan al menos una de varias palabras, incluye OR (en mayúsculas) entre las palabras. Si no se incluyera OR, normalmente los resultados mostrarían solo páginas que coincidan con ambos términos. También puedes utilizar el símbolo | entre las palabras para causar el mismo efecto.    
[ sede olimpiadas 2014 OR 2018 ]      Sugerencia: incluye frases entre comillas para buscar al menos una de varias frases.     
[ "copa del mundo 2014" OR "olimpiadas 2014" ]  
Buscar un intervalo de números
número..número
Separa números con dos puntos (sin espacios) para obtener resultados que contengan los números incluidos en un intervalo determinado de cosas como fechas, precios y medidas.    
[ cámara "50..100 euros" ]       Sugerencia: utiliza solo un número con dos puntos para indicar un límite superior o un límite inferior.     
[ ganadores copa del mundo ..2000 ]  

Continuando, llega el momento de hacer referencia a los operadores, "los buscadores los emplean para hacernos la vida mas sencilla"; estos están allí para brindarnos resultados mucho mas específicos y viene de madre conocerlos...
 
-->
Operador Propósito Combinable Usado solo
intitle Busca en el titulo si si
allintitle Busca el titulo no si
inurl Busca en la URL si si
allinurl Busca la URL no si
filetype Permite espeficicar el tipo de archivo que se desea si no
allintext Busca en el texto solamente No en realidad si
site Buscan en un sitio especifico si si
link Busca enlaces a otras paginas no si
inanchor Buscan en las Anclas si si
numrange
Localiza un numero
si si
daterange Busca un rango de datos si no
author Busca por autor si si
group Busca el nombre del grupo No en realidad si
insubject Busca el asunto si si
msgid Busca el msgid del grupo no si

Pueden encontrar mas detalles en el articulo original en wikipedia -Ingles- (aquí).

Finalmente llega el momento de tratar el punto que posiblemente sea lo que llame la atención a muchos... Google hacking !!!. Primero que nada en este sentido debo advertir que no se trata de nada ilegal (aunque lo que hagan con los resultados si puede traer problemas y va bajo su propio riesgo y responsabilidad), lo que vamos a hacer es hacer busquedas especificas sobre elementos que los sysadmin no han debido dejar al descubierto o no han de haber permitido que se indexe por google.

Formalmente hablando, el google hacking se describe como (extraído de  Taringa ):

"... consiste en explotar la gran capacidad de almacenamiento de información de Google, buscando información específica que ha sido añadida a las bases de datos del buscador. Si las búsquedas las orientamos a ciertas palabras clave que nos ayuden a encontrar información sensible, puntos de entrada sensibles a posibles ataques, como por ejemplo, este o cualquier otro tipo de información que tuviera carácter de sensibilidad, estaremos ejecutando un Google hack. Resumiendo: Google Hacking es buscar en Google información sensible ..."

Ahora, antes de poder hacer cualquier hacking es necesario conocer la forma en la que funciona google, para ello vamos a usar como base la explicación de segu-info.com.ar (para que reinventar la rueda no ??).

" Google no es más que un gran procesador de comandos y mientras mejor sea la combinación que usemos, mejores serán los resultados obtenidos. Como todos sabemos si colocamos una palabra en el cuadro de texto, Google entenderá que debe realizar la búsqueda de esa palabra. Pero si colocamos: (e^(i * pi)) + 1 entonces Google entenderá que deseamos realizar una operación matemática (la entidad de Euler, la fórmula más importante del mundo) y nos dará el resultado de la misma que es 0 (cero) en este caso.

Este buscador, basa su gran potencia en el algoritmo que utiliza; este se basa en complejas funciones matemáticas -mejoradas día a día- , que tienen como objetivo obtener la posición que cada página debe ocupar en el ranking.

Esta posición - PageRank- se logra mediante una valoración objetiva de la importancia de la página web a buscar; El resultado es un número de 0 a 10 que arrojado luego de aplicar una ecuación matemática compuesta por más de 500 millones de variables y 3.000 millones de términos.

El algoritmo en cuestión, se aplica a las paginas indexadas y para esta tarea -indexación-, Google dispone de robots llamados Googlebots que se encargan de almacenar cada sitio web e indexarlo en las bases de datos. Es decir que nuestro amigo funciona como un inmenso repositorio de nuestras webs.


En la imagen puede verse la última vez que el robots de Google ha revisado Segu-Info, la cantidad de páginas indexadas y la cantidad de MegaBytes de información almacenados en su base de datos. 

Esta base tiene dos objetivos:
  • realizar las búsquedas sobre ella para evitar la búsqueda en los sitios reales, con la pérdida de performance asociada.
  • permitir visualizar las páginas que ya no están online pero han sido indexadas en alguna oportunidad. Esta funcionalidad recibe el nombre de caché. ".
Dicho esto, al grano...

En la actualidad es posible encontrar un gran numero de post, artículos, E-books, libros y demás sobre el tema; por lo cual lo que aquí veremos debe ser considerado solo como un pequeño abre boca.

En cada uno de los casos descritos, emplearemos los consejos, filtros y operadores descritos al inicio:

1.) Localizar archivos que no deberían estar públicos:
  a.) Correos: filetype:pst inurl:[siente libre de probar], filetype:mbx mbx intext:Subject
  b.) Logs de aplicaciones: +htpasswd +WS_FTP.LOG filetype:log
  c.) Archivos con contraseñas o confidenciales:
     *) filetype:bak createobject sa (Lineas de conexión ADODB)
2.)Localizar archivos en la cache:
  a.) Errores de aplicaciones: "ORA-00936: missing expression"
3.)Localizar configuraciones por defecto:
  a.) De apache: intitle:"Test Page for Apache" "It Worked!"
  b.) De IIS: intitle:"Welcome to IIS"
4.)Localizar Errores de Configuración:
  a.) Búsqueda de vulnerabilidades: "VNC Desktop" inurl:5800

Finalmente, hora de nuevamente hacer la aclaración, estas búsquedas no son ilegales, pero puede meternos en problemas lo que hagamos luego con los conocimientos y resultados obtenidos...

"Con un gran poder viene una gran responsabilidad"

viernes, 30 de noviembre de 2012

Como saber el número de HBA's en un equipo

Por cosas de trabajo (si, para no perder la costumbre), me he visto en la necesidad de conocer el numero de HBA's conectadas a un equipo, y ya que me ha tomado algo de tiempo la búsqueda, he decidido centralizar las alternativas encontradas para ello, luego de mucho probar he encontrado las siguientes alternativas:

  1. # lspci | grep -i fibre
  2. ls /sys/class/fc_host/
  3. cat /proc/scsi/[driver]/ hierarchy

jueves, 20 de septiembre de 2012

Proxy en Yum

Ya hace mucho tiempo escribi un articulo sobre como indicar a aptitude que se encontraba tras de un proxy, en esta oportunidad; voy a hablar sobre como indicarle a yum que se encuentra tras un proxy y mas aun indicarle los parametros de Autentificación a Yum

El Escenario:

Tenemos un equipo con una distro .RPM que se encuentra tras un proxy que emplea autentificación.

Como Proceder:

Lo que debemos es habilitar el proxy en Yum e indicarle los parametros de autentificación y esto lo hacemos simplemente editando el archivo de configuración de yum, el /etc/yum.conf

Básicamente lo que haremos será editar el archivo /etc/yum.conf y definir los parámetros proxy, proxy_username y proxy_password indicandole los valores del proxy, el usuario y su password:

# The proxy server - proxy server port number
proxy=http://vsnlproxy.iitk.ac.in:3128/
# The account details for yum connections
proxy_username=spsingh
proxy_password=password

Ya definidos estos parámetros simplemente guardamos, cerramos y probamos ejecutando yum.


martes, 18 de septiembre de 2012

Chuleta /etc/shadow

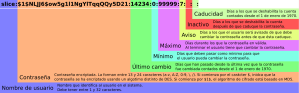
El archivo /etc/shadow almacena información sobre las contraseñas cifradas de los usuarios de nuestro sistema, al igual que el /etc/passwd, es una archivo de lista (los ":" son el separador de columnas), cuya estructura es:


martes, 11 de septiembre de 2012

Cambiar nombre host

Como muchas de las cosas en mi blog, son las necesidades del trabajo las que me llevan a escribir (a fin y al cabo estas son mis notas personales), en cualquier caso, la entrada de hoy esta dedicada al cambio del nombre del Host.

El procedimiento que ahora describo esta probado en RHEL, aunque debería funcionar igual en otras distribuciones...

  • Editar el archivo network (/etc/sysconfig/network) y cambiar el nombre del host en la variable HOSTNAME.
  • Editamos el archivo /etc/hosts agregando la info del equipo (192.168.0.1 nombre).
  • Cambiamos el nombre del host usando el comando hostname.
hostname redhat9
  • Ejecutar nuevamente el comando hostname sin incluir el host para ver el cambio.
  • Finalmente reiniciar el servicio de red para aplicar los cambios realizados (service network restart).
  • Para verificar que el nombre del host fue realmente cambiado debemos salir e ingresar nuevamente a la sesión.

viernes, 7 de septiembre de 2012

remontar fichero de solo lectura

Producto del día a día en el trabajo, y haciendo una de esas actividades que se hacen repetitivas (y con los ojos cerrados), sin querer agrege un dispositivo al /etc/fstab y expecifique mal su UUID. Este echo, junto el pequeño problema del punto de montaje de este dispositivo hizo que al reiniciar el equipo mi sistema reportara un error y me dejara en una consola.

Al principio pense que todo seria sencillo, corria un blkid, revisaba el UUID y luego entraba al /etc/fstab y solucionaba el error; pero la realidad fue otra, ya que al intentar solucionar el error me encontre con que el sistema (/) se había montado solo lectura....

Al principio pensé forzar la escritura o cambiar permisos, pero no funciono, entonces vi la luz:

# mount -o rw,remount /dev/sdaX

De esta forma se pide que se monte (o remonte) el dispositivo /dev/sdaX  como lectura y escritura.

martes, 4 de septiembre de 2012

Saludo Consola Grafica

Desde que lo vi en Iron man II, he estado con la cosa de modificar el comportamiento de mis consolas obligándolas a mostrar un mensaje personalizado al momento de llamarlas, al fin he tenido un poco de tiempo para realizar esto y mas aun para publicar como se hace.

En realidad, esto es algo muy sencillo de hacer, lo que debemos simplemente es editar los detalles de nuestro perfil, para ello modificamos el archivo "bashrc" que se encuentra en nuestro home (ojo es un archivo oculto -inicia en punto ".")

Personalizando el saludo para nuestro usuario:


  • Editamos el archivo bashrc de nuestro usuario ingresando a la ruta /home/bashrc
  • Agregamos al final el mensaje que queremos que aparezca:


  • Cerramos y lanzamos una nueva consola para ver los resultados:


Personalizando para Root:


De similar manera podemos proceder para el saludo de root, solo que en este caso, el archivo se encuentra en /root/.bashrc.


Definiendo un Alias:

Finalmente, para terminar este tema, es importante comentar los "alias", esto hablando en criollo son nicks que podemos definir para la lista de comandos que mas usamos, y para ello simplemente debemos agregar una linea como la que sigue el el .bashrc del usuario:

echo 'alias imagenes="cd /media/discoduro/archivos/Pictures"' >> ~/.bashrc && . ~/.bashrc 
 

La ultima parte de este comando simplemente lo que hace es regargar el bash.

Si queremos verificar que todo ha salido bien, simplemente ejecutamos el alias o tecleamos:

alias

para ver la lista de nicks definidos.

ssh sin contraseña


Muchas veces en el día a día de un sysadmin, nos es necesario automatizar tareas las cuales implican conexiones remotas, estas situaciones ponen al administrador ante la necesidad de poder hacer login remoto sin tener que el mismo escribir la contraseña de autentificación.

Para solucionar esta necesidad, existe el metodo de autentificación por llaves en el protocolo ssh, el cual permite evitar la necesidad de teclear la contraseña al establecer conexión con los host.

Habilitar este comportamiento es muy sencillo, simplemente es necesario realizar lo siguiente:

Generar las llaves de ssh:

  • Para ello ejecutamos: # ssh-keygen -t dsa:

Transferir la llave publicas al remoto:

  •  Nos valdremos en este caso de la utilidad  "ssh-copy-id" :

Probar la conexión:

  • Realizamos una conexión con el usuario y el host especificado en el paso anterior:

    ssh usuario@equipo
Si todo ha ido bien, debemos podemos ingresar al equipo y no debe habernos solicitado contraseña.

Cinnamon en Fedora 17 (RHEL)

Cinnamon:

Tal como leemos en wikipedia: "Cinnamon es una bifurcación de GNOME Shell, desarrollado inicialmente por Linux Mint. Intenta proveer un entorno de escritorio más tradicional basado en la metáfora de escritorio, como GNOME 2. Cinnamon usa Muffin, una bifurcación del gestor de ventanas de GNOME 3 Mutter, como su gestor de ventanas".


Para mucho de nosotros, este entorno nos ofrece mucho de lo bueno del nuevo Gnome 3, pero desde una interfaz mas acorde con lo que estamos acostumbrados.

Actualmente, cinnamon no se encuentra en los repositorios de Fedora, pero podemos agregar un nuevo repo e instalar desde allí, para ello ejecutamos:

# curl http://repos.fedorapeople.org/repos/leigh123linux/cinnamon/fedora-cinnamon.repo -o /etc/yum.repos.d/fedora-cinnamon.repo

Con lo anterior nos bajaremos e instalaremos un nuevo repo a la lista de nuestro yum, ahora como es costumbre es necesario ejecutar un update para poder ver la lista de paquetes que este nos ofrezca, para ello ejecutamos:

# yum check-update

Una vez terminado el proceso de update (puede ser mas o menos rápido dependiendo de nuestra conexión y otras variables), es necesario instalar el paquete de cinnamo; bastará simplemente con ejecutar:

# yum install cinnamon

Terminada la instalación simplemente debemos cerrar la sesión actual y logearnos nuevamente, recordando seleccionar Cinnamon como entorno de escritorio.

Grub-customizer (RHEL)

En esta oportunidad, vamos a ver una nueva alternativa para jugar con la configuración de nuestro Grub... Esa pantalla que sin duda alguna se convierte en la primera impresión de nuestro sistema ante los demas y que puede decir mucho de nuestros equipos.

Si, en general modificar el grub es muy sencillo, es cosa simplemente de editar un archivo y listo !!!, ok, es verdad pero para aquellos que no quieren introducirse en ese mundo y prefieren una gui que les ayude, aquí encontrarán una gran aplicación.

Grub-customizer:


Lo que debemos hacer, es simplemente instalar la fuente, lo malo es que por ahora no se encuentra en los repositorios de distros RPM's, por lo que simplemente debemos ingresar a la Web del proyecto y bajarnos el rpm:

Una vez descargado, la cosa es simplemente instalarlo, para ello nos movemos al directorio donde lo bajamos y le damos doble click...

Luego de instalado, podemos ejecutarlo con el comando grub-customizer.

MS Sql en RHEL

Por motivos de trabajo, he tenido al fin la necesidad de conectar desde Linux con una base de datos de MS-Sql y como siempre paso por aca para dejar la receta de como hacerlo. El proceso es bien sencillo y simplemente es necesario bajarnos un par de paquetes, realizar la configuración y listo, ya tendremos nuestra conexión operativa.

El escenario al que aplica este articulo es uno en el que tienes una aplicación que requiere conectarse a un segundo equipo donde se ejecuta el MS-Sql. Para el caso especifico, tenemos un equipo con una aplicación desarrollada en php, el cual ya tiene instalado el servidor apache y el php.

En cualquier caso, y esto sobre todo para aquellos que quieran documentarse un poco mas, es esta solución vamos a emplear la biblioteca Freetds (I,II) y el paquete php-mssql el cual nos permite hacer uso de las funciones Ms-Sql dentro de nuestro código php.

El proceso

Lo que debemos hacer primeramente es instalar los siguientes paquetes:

  • Freetds,
  • Php-mssql (o el equivalente para el lenguaje en el que tenemos el desarrollo).
Normalmente, el proceso se limitaria a ejecutar:

# yum install  freetds.arch php-mssql.arch

* donde arch hace referencia a la arquitectura de nuestra plataforma.

Luego de realizada la instalación de los paquetes es momento de realizar la configuración del TDS, para ello simplemente debemos modicar el archivo de configuración del tds e indicarle los parámetros de nuestro servidor.

  • Accedemos al archivo /etc/freetds.conf
# vi /etc/freetds.conf
  • Ubicamos la linea (A typical Microsoft server) y procedemos a modificarla.
  • Agregamos los parametros de configuración en base a nuestro escenario asi:
# A typical Microsoft server
[NombreServidor]
        host = Dirección IP
        port = puerto
        tds version = VersiónDelTDS
 
 
Es muy importante, que los parámetros estén bien configurados dentro del archivo para que de esta forma nuestra aplicación se pueda conectar de manera correcta, en tal sentido, debemos incluso asegurarnos de tener correctamente seleccionado la versión del TDS (varia en base a la versión de MS-Sql que use nuestro server).

Dentro del /etc/freetds, también podemos habilitar el registro de log, el cual es muy útil a la hora de monitorear y de hacer diagnostico de errores, para ello simplemente debemos descomentar la opción de dump en el log.

Finalmente, podemos probrar que todo este bien ejecutando:

# tsql -S NombreServidor -p Puerto -U UsuarioBaseDatos

Esto nos debería permitir conectarnos al servidor especificado.